urMQTT na prawdziwym VPS-ie ARM64: bez ekranu, bez sprzętowego generatora liczb losowych i z handshakiem, który był za wolny
Co się wydarzyło po tekście o v0.3.0: pierwsze uruchomienie na prawdziwym serwerze aarch64 z KVM (instalacja na jego dysku, utrata zasilania, liczby dotyczące dysku), wpis diagnostyczny, który raportuje przez sieć, bo konsola jest niewidoczna, co ustalił o generatorze liczb losowych, asembler P-256 dla ARM64, który zwiększył częstość pełnych handshaków około 1,5 raza, oraz błędy, które popełniliśmy po drodze.
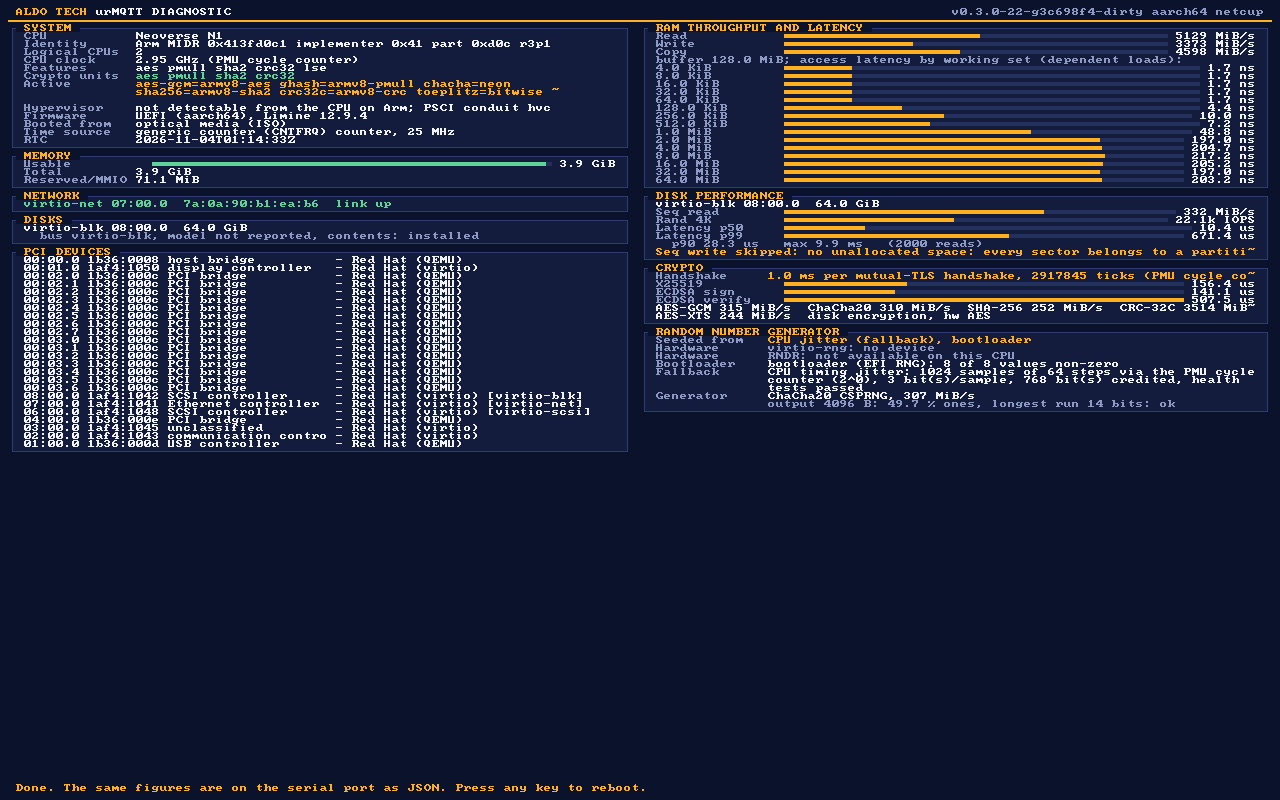
Poprzedni tekst, urMQTT v0.3.0, kończył się czterema pozycjami w części „Co dalej": decyzja o publicznym brokerze demonstracyjnym (D1), fuzzing parserów PCI i virtio oraz test zablokowanych tablic stron, okno dialogowe klucza na stronie konstruktora i bare metal. Żadna z czterech nie została zrobiona w tej rundzie i mówimy to na początku. Zrobiliśmy za to to, czego przez cały czas brakowało: uruchomiliśmy urMQTT na prawdziwym serwerze ARM64 pod KVM, i prawie wszystko poniżej pochodzi z tej jednej maszyny. Pierwsza pozycja starej listy, CI, została uporządkowana (wcześniejszy tekst i notatki do wydania, które nazywały je czerwonym, poprawiliśmy).
Zastrzeżenie na wstępie pozostaje to samo: projekt jest w fazie pre-alfa, liczby mierzą kod, testy i konkretne eksperymenty na jednej maszynie, nie dojrzałość w produkcji. Tam, gdzie liczba nie została zmierzona na maszynie docelowej, mówimy o tym.
Jak to wyglądało w czasie
Od ostatniego tekstu (3 listopada, 02:43) do dziś (4 listopada, 03:18) w gałęzi main jest 29 nowych commitów, łącznie 244. Jak poprzednio, projekt powstaje z Claude Code (commity zawierają Co-Authored-By: Claude). Liczby obliczono metodą z dwóch ostatnich tekstów (wszystkie pliki .rs poza vendor/ i fuzz/, funkcje #[test], nagłówki ## ADR- w docs/DECISIONS.md); na starym commicie metoda daje takie same liczby jak wtedy.
| Moment | Commit | Czas | Linii Rusta | Testów | ADR-ów | Commitów |
|---|---|---|---|---|---|---|
| ostatni tekst | f1a7fbc | 3 listopada, 02:43 | 115 148 | 962 | 133 | 215 |
| dziś | efddf6e | 4 listopada, 03:18 | 117 084 | 978 | 134 | 244 |
Przyrost: +1 936 linii, +16 testów, +1 ADR. Znów mało nowego kodu; sam asembler P-256 (1 509 linii) jest przejęty (vendored) i nie wchodzi do liczby linii.
Druga prawdziwa maszyna
Dotąd projekt miał jeden prawdziwy serwer: VPS-a Contabo z AMD EPYC (x86_64, KVM), na którym działało porównanie wydajności z Mosquitto. ARM64 działał tylko w QEMU, na Macu ze sprzętową akceleracją, a w CI bez niej. Nowa maszyna to netcup VPS 500 ARM G12.5: rdzeń Neoverse N1 przy około 3 GHz, 2 vCPU, 3,9 GiB RAM, dysk virtio 64 GiB, QEMU/KVM z firmware UEFI, karta sieciowa virtio. Wszystko sterowaliśmy przez REST API dostawcy za pomocą klienta wiersza poleceń: wgrywamy ISO, podłączamy je jako wirtualną płytę CD, przełączamy urządzenie rozruchowe, wyłączamy i włączamy zasilanie.
Co na niej zrobiliśmy, po kolei:
- Najpierw migawka oryginalnego systemu. Przy UEFI migawka online nie jest możliwa, więc serwer został wyłączony i wykonano migawkę offline.
- Instalacja. Instalator z ISO zapisał obraz na dysku (razem z 30-sekundowym odliczaniem około 40 sekund) i sam wyłączył maszynę, zgodnie z projektem.
- Rozruch z zainstalowanego dysku trwał około 35 sekund do handshaku TLS.
- Zachowana (retained) wiadomość przetrwała twarde odcięcie zasilania. Opublikowaliśmy ją, odcięliśmy zasilanie przez API, uruchomiliśmy ponownie i odczytaliśmy.
- Zainstalowany dysk, zmierzony wpisem diagnostycznym (tylko odczyt; test zapisu pominięto, bo zainstalowany układ nie zostawia nieprzydzielonego miejsca, co jest zamierzone): odczyt sekwencyjny 332 MiB/s, losowe odczyty po 4 KiB 22 147 na sekundę z p50 10,4 µs, p90 28,3 µs, p99 671 µs, maksimum 9,9 ms (2 000 odczytów).
Pięć pozycji to nie zestaw testów: to jedna maszyna, po jednym uruchomieniu każdego i ścieżka instalacji sprawdzona raz na prawdziwym dysku. Pokazuje jednak, że własny sterownik virtio-blk jądra, instalator i rozruch działają na prawdziwym gościu w chmurze, a nie tylko w laboratoryjnym emulatorze.
Bez ekranu, więc diagnostyka idzie przez sieć
Wpis diagnostyczny z v0.3.0 rysuje swoje liczby w framebufferze. Na tym serwerze konsola dostawcy pokazuje „Display output is not active": maszyna wirtualna ma kartę graficzną virtio, do której nie mamy sterownika, a port szeregowy nie jest wystawiony. Liczby istniały i nikt nie mógł ich odczytać.
Rozwiązaniem jest słowo rozruchowe diag-serve: maszyna wykonuje te same pomiary, potem uruchamia się jako zwykły działający broker i publikuje raport jako jeden dokument JSON w zachowanej wiadomości $SYS/diag/report, którą może czytać tylko certyfikat operatora. Małe narzędzie urmqtt-diag-png rysuje z tego JSON-a panel tym samym kodem, którego jądro używa na ekranie (ten sam układ, ta sama czcionka 8x8), więc obraz jest tym ekranem, który maszyna by pokazała:
Po drodze dodaliśmy do ekranu dwie rzeczy, bo ich brakowało: taktowanie CPU (licznik cykli PMU względem bazy czasu: tutaj od 2,95 do 2,98 GHz; tam, gdzie czytelny jest tylko zegar o stałej częstotliwości, widnieje „niemierzalne" zamiast podawania częstotliwości zegara jako częstotliwości CPU) oraz panel generatora liczb losowych.
Z czego składa się generator liczb losowych
Panel podaje, skąd generator został zasiany, i testuje świeże bajty z każdego źródła sprzętowego. Na tej maszynie mówi:
- virtio-rng: brak urządzenia.
RNDR(własna instrukcja CPU): niedostępny na tym CPU. - Generator liczb losowych EFI loadera: 8 z 8 wartości niezerowych.
- Rezerwa oparta na jitterze taktowania CPU (ADR-038): 1 024 próbek po 64 kroki przez licznik cykli PMU, szacunkowo 3 bity na próbkę, zaliczono 768 bitów (jedna czwarta szacunku, zgodnie z założeniem), testy kondycji zaliczone.
- Wyjście generatora, test poprawności na 4 096 bajtach: 49,6 % jedynek, najdłuższy ciąg 16 bitów. To sprawdzenie, że nic nie utknęło i nie jest przekrzywione, a nie certyfikacja statystyczna.
Generator na tym serwerze opiera się więc na rezerwie z jitterem i na tym, co przekazał firmware. Dokładnie to opisuje ADR-038 i jest to najsłabsze zasianie, jakie jądro akceptuje. Nie nazywamy go zepsutym: zaliczone bity są powyżej progu, którego jądro wymaga (256), a estymator jest zachowawczy. Nie możemy też udowodnić, że jest tak dobry jak źródło sprzętowe. Czy obraz produkcyjny powinien odmawiać rozruchu bez źródła sprzętowego, chyba że operator się na to zgodzi, to otwarte pytanie do właściciela (jest na mapie drogowej, poniżej). W praktyce jest to pytanie także do dostawcy: sprzętowe urządzenie liczb losowych dla maszyny wirtualnej by to rozstrzygnęło.
Handshake, który był za wolny
Wpis diagnostyczny pokazał też, ile na serwerze kosztuje pełny handshake TLS z wzajemnym uwierzytelnieniem: 1,08 ms. Prawie wszystko to arytmetyka kluczy publicznych: dwie weryfikacje ECDSA P-256 (certyfikat klienta i dowód klienta), po około 508 µs każda, X25519 176 µs, jeden podpis ECDSA 141 µs. Na x86_64 rozwiązaliśmy to wcześniej (ADR-130, asembler OpenSSL/Intel: P-256 trzy do czterech razy szybszy); na ARM64 nadal działał przenośny kod RustCrypto.
To samo zrobiliśmy dla ARM64 (ADR-255). Asembler to nistz256 dla ARMv8 z OpenSSL (Apache-2.0), wzięty z ring 0.17.14 i przejęty (vendored) z zapisem pochodzenia i każdej mechanicznej zmiany. Co miało znaczenie w szczegółach:
- Tylko liczby całkowite. Asembler nie używa rejestrów NEON. Dwie funkcje wyboru z tablicy, które upstream implementuje z NEON, odrzuciliśmy i napisaliśmy w ich miejsce maskowane przeszukania w stałym czasie w Ruście (kosztują co najwyżej 1,4 µs z 12 µs podpisu).
- Ochrona skoków. Jądro jest kompilowane z BTI i uwierzytelnianiem wskaźników. Każdy z 8 eksportowanych punktów wejścia ma landing pad, sprawdzony w deasemblacji jądra, a sześć z nich, które zapisują rejestr łącza, podpisuje go.
- Testy, bo to kryptografia w bazie, której ufamy. Cały zestaw dla x86_64 działa teraz także na aarch64 Linux: arytmetyka ciała i skalarów względem szkolnej referencji, cała tablica generatora (2 368 pozycji) względem RustCrypto, podpisy bit w bit równe podpisom RustCrypto, werdykty weryfikacji, ECDH z wejściami spoza krzywej i zerowymi oraz testy ze znanymi odpowiedziami, które działają przy każdym rozruchu na ścieżkach produkcyjnych. W czterordzeniowej maszynie wirtualnej pod burzą przerwań wykonano 59 526 rund testów ze znanymi odpowiedziami z 0 niezgodności.
- Test czasowy z kontrolą i sygnał, który był naszym własnym testem. Celowo nieszczelne mnożenie uzyskuje |t| od 482 do 1755, więc test widzi wyciek w tej skali. Na rdzeniu Apple w kontenerze ECDH uzyskał 0,2 do 2,1, podpis 0,5 do 1,9, generowanie klucza 0,8 do 5,5. Na rdzeniu serwerowym arm64 runnera CI podpis ECDSA uzyskał |t| = 8,6, 9,1 i 8,3 w trzech próbach, powyżej naszej granicy 7, podczas gdy ECDH (3,9) i generowanie klucza (1,9) przeszły na tej samej maszynie. Wynik, który się powtarza, nie jest szumem, więc zapisaliśmy go jako otwarte ustalenie (A255-W1) i na kilka godzin podnieśliśmy granicę dla tego jednego przypadku do 12, żeby build mógł przejść. Potem znaleźliśmy przyczynę i była nią uprząż testowa: przypadek podpisywał jedną stałą wiadomość, więc rzadki klucz dawał za każdym razem ten sam podpis, a losowe klucze za każdym razem inny, a kodowanie DER powtarzającego się podpisu jest szybsze (|t| od 49 do 57 samego kodowania). Przy losowej wiadomości w każdym pomiarze, w obu klasach, przypadek uzyskuje na runnerze (maszynie wirtualnej Neoverse N2) 1,4 i 1,8, sama generacja nonce 2,7 i 1,1, a granica wróciła do 7. Jedna rzecz pozostaje otwarta (A255-W2): flaga procesora, która czyni czas mnożnika niezależnym od danych na rdzeniach Arm (DIT), nie jest ustawiana nigdzie, ani przez jądro, ani wokół wywołań po stronie hosta. Żaden pomiar nie pokazuje różnicy, ale maszyna wirtualna runnera nie udostępnia tej funkcji, więc test też nie mógł jej pokazać.
Co to dało
Najpierw mikrobenchmark na maszynie, na której rozwijaliśmy, Apple M4 Pro (to nie procesor docelowy, więc proporcje na serwerze mogą się różnić), tym samym kodem, który wywołuje handshake, przed i po:
| Operacja | przed (µs) | po (µs) | stosunek |
|---|---|---|---|
| generowanie klucza | 30,8 | 7,0 | 4,4x |
| ECDH P-256 | 135,2 | 25,0 | 5,4x |
| podpis ECDSA | 34,7 | 11,6 | 3,0x |
| weryfikacja ECDSA (nieznany klucz) | 147,4 | 29,1 | 5,1x |
| weryfikacja CA (zarejestrowany wystawca) | 54,2 | 9,6 | 5,6x |
| X25519 (kod bez zmian) | 20,4 | 20,1 | 1,0x |
| szacunek handshaku (suma powyższych) | 292 | 104 | 2,8x |
Potem prawdziwy test: ten sam generator obciążenia, ta sama metoda co we wcześniejszym tekście o wydajności (pełny handshake TLS 1.3 z certyfikatem klienta, bez wznowienia, MQTT CONNECT, serwer zamyka pierwszy), uruchomiony z maszyny oddalonej o 9 ms od serwera, wobec tego samego VPS-a netcup, przed zmianą i po niej. Obraz do benchmarku ma poluzowane limity handshaku, jak w porównaniu na x86_64; trzy powtórzenia, liczba to mediana.
| Wątki | przed (poł./s) | po (poł./s) | stosunek | błędy |
|---|---|---|---|---|
| 32 | 848 (408-855) | 1 317 (957-1 317) | 1,55x | 0 |
| 64 | 827 (815-839) | 1 398 (1 352-1 416) | 1,69x | 0 |
| 128 | 778 (714-788) | 1 316 (1 313-1 383) | 1,69x | 0 |
| część TLS połączenia, p50, 32 wątki | 18,5 ms | 13 ms |
Liczba pełnych handshaków na sekundę wzrosła około 1,55 do 1,7 raza, a nie trzykrotnie, jak dałaby sama arytmetyka. Powód jest prosty i warto go powiedzieć: przyspieszyliśmy P-256, a X25519 (176 µs), stos TCP/IP, warstwa rekordów i MQTT pozostały bez zmian, więc pozostała część zyskuje na znaczeniu (prawo Amdahla). Następnym kandydatem jest X25519.
Dla orientacji obok serwera x86_64 z wcześniejszego tekstu. To nie jest porównywalne jako wyścig: inne CPU, inna liczba rdzeni (4 wobec 2), inna odległość do generatora (15 ms wobec 9 ms) i w obu przypadkach współdzielona maszyna z generatorem obciążenia, która podczas uruchomień traciła od 5 do 60 % własnego CPU. Porównywalna jest kolumna z kosztem CPU samego serwera na handshake:
| Contabo, x86_64 EPYC (asm) | netcup, ARM64 N1 przed | netcup, ARM64 N1 po | |
|---|---|---|---|
| CPU serwera na handshake | 0,26 ms (konsola brokera) | 1,08 ms (Diagnostyka) | 0,55 ms (Diagnostyka, jedno uruchomienie, zob. niżej) |
| handshaków/s, 32 wątki | 169 (bench) | 848 | 1 317 |
| handshaków/s, 64 wątki | 278 (bench) | 827 | 1 398 |
| handshaków/s, 128 wątków | 413 (bench) | 778 | 1 316 |
Tego samego dnia wpis diagnostyczny uruchomiono ponownie na tej maszynie, z asemblerem (w buildzie, który zawiera też sterownik grafiki opisany w aktualizacji na końcu): koszt CPU serwera jednego handshaku z wzajemnym TLS wyniósł 553 µs wobec 1,08 ms wcześniej, czyli 1,95 raza mniej. Weryfikacja ECDSA zajęła 192 µs (wcześniej 508 µs), podpis 78 µs (141 µs), a X25519 209 µs (176 µs; ten kod jest niezmieniony, a zegar CPU w tym uruchomieniu wynosił 2,58 GHz wobec 2,95 do 2,98 GHz we wcześniejszych, więc pojedyncze liczby na tej współdzielonej maszynie zmieniają się o dziesiątki procent). To jedno uruchomienie, na współdzielonym hoście. To, że częstość handshaków wzrosła 1,55 do 1,7 raza, a własny koszt serwera na handshake spadł 1,95 raza, daje się pogodzić: reszta połączenia to stos, generator i sieć. Szum między uruchomieniami widać w surowych plikach: każda trójka ma jedną wartość odstającą (408 przed i 957 po przy 32 wątkach), gdy maszyna z generatorem obciążenia straciła większość swojego CPU na rzecz innych maszyn wirtualnych. Przy 128 wątkach na granicy jest generator, nie serwer, na obu maszynach.
Reszta zestawu na tej maszynie
Ten sam zestaw co dla serwera x86_64 (przepustowość, opóźnienie, rozsyłanie, bezczynne połączenia) przeszedł w całości wobec nowego builda. Dla tych wierszy nie ma „przed": uruchomienie zatrzymano, aby zbudować asembler, więc to stan po zmianie, a asembler nie dotyka tych ścieżek poza handshakami, które otwierają połączenia. Jeden fakt wyjaśnia większość tego, co następuje: ta maszyna wirtualna ma dwa vCPU. Rdzeń 0 obsługuje kartę sieciową, rozdzielanie oraz całą pracę MQTT i TLS, rdzeń 1 jest rdzeniem bazy danych i przez cały czas był obciążony na 2 do 3 %. Serwer x86_64 miał cztery vCPU i dwa rdzenie robocze. Wszystko poniżej to zatem wydajność brokera na jednym rdzeniu.
| Bezczynne połączenia | 5 000 | 10 000 | 20 000 |
|---|---|---|---|
| połączono | 5 000 z 5 000 w 4,3 s | 10 000 w 9,3 s | 20 000 w 21,2 s |
| przyrost sterty jądra na połączenie | 0,34 KB | 0,41 KB | 0,43 KB |
| błędy | 0 | 0 | 0 |
(0,50 do 0,66 KB na połączenie na serwerze x86_64 przy commicie H7. Liczba dotycząca sterty to $SYS/broker/memory/used minus jego wartość przed pierwszym połączeniem.)
| Opóźnienie przy umiarkowanym tempie (8 par x 100 wiadomości/s, 64 B) | p50 | p99 |
|---|---|---|
| QoS 0 | 4,0 ms | 6,9 ms |
| QoS 1 | 4,1 ms | 7,0 ms |
| Rozsyłanie (1 publikujący, 64 B) | dostarczone na sekundę | p50 | p99 |
|---|---|---|---|
| 100 subskrybentów, QoS 0, 50 wiadomości/s | 5 000 (wszystkie) | 5,9 ms | 8,6 ms |
| 100 subskrybentów, QoS 1, 50 wiadomości/s | 5 000 (wszystkie) | 6,3 ms | 10,0 ms |
| 1 000 subskrybentów, QoS 0, 10 wiadomości/s | 8 805 z 10 000 | 207 ms | 5,4 s |
| Zalew, 16 par, publikujący tak szybko, jak broker przyjmuje | opublikowane/s | dostarczone/s | p50 / p99 | utracone połączenia |
|---|---|---|---|---|
| QoS 0, 64 B | 231 317 | 85 140 | 1,36 s / 2,8 s | 0 |
| QoS 0, 1 KiB | 62 110 | 25 506 | 336 ms / 873 ms | 0 |
| QoS 1, 64 B | 107 349 | 55 965 | 21 ms / 29 ms | 0 |
| QoS 1, 1 KiB | 51 369 | 25 054 | 47 ms / 60 ms | 0 |
| QoS 1, 64 B, 64 par | 130 462 | 69 411 | 69 ms / 87 ms | 0 |
Jak to czytać. Opóźnienie przy umiarkowanym tempie to wkład brokera plus jedna podróż do generatora: generator jest bliżej tego serwera niż ten w porównaniu na x86_64, więc obie kolumny opóźnienia nie są porównywalne. Zalew QoS 0 pokazuje zwykły obraz przeciążonego pojedynczego rdzenia: broker przyjmuje 231 000 wiadomości na sekundę i dostarcza 85 000 (resztę odrzucają reguły przeciwciśnienia, po to tam są) z opóźnieniami rzędu sekund i żadne połączenie nie zostało utracone; na serwerze x86_64 taki sam zalew kosztował kilka połączeń na uruchomienie z powodu 20-milisekundowego watchdoga (ADR-221 od tego czasu zmienił sposób liczenia tego budżetu). Wiersz z 1 000 subskrybentów ma ten sam charakter co wcześniej, ogony rzędu sekund, częściowo własne generatora. Liczby przy commicie H7 na serwerze x86_64 są we wcześniejszym tekście; nie umieszczamy ich w jednej tabeli z tymi, bo między dwoma pomiarami zmienił się kod na ścieżce danych (ADR-221 do ADR-224), a maszyny różnią się we wszystkim.
Błędy, które sami znaleźliśmy
- Obraz mówił „nie znaleziono dysków", a dysk był w raporcie. Pierwsza wersja
urmqtt-diag-pngw ogóle nie czytała poladisks. Właściciel projektu spojrzał na obraz, powiedział, że wygląda źle, i miał rację. Poprawione, a test odczytuje teraz dysk z JSON-a. - Uznaliśmy instalator za skończony za wcześnie. Stan serwera przeszedł na „off" dwa razy: raz na końcu cyklu zasilania i raz, gdy instalator skończył. Nasz skrypt wziął pierwsze za drugie, odłączył ISO i uruchomił stary system, który zgłosił stary numer wersji i kazał nam szukać w instalatorze usterki, której tam nie było. Skrypt czeka teraz najpierw na świeży rozruch.
- Zgubiła się historia postępu. Analiza do mapy drogowej wykazała, że commit kamienia milowego S6 zastąpił
docs/PROGRESS.md(1 763 linie, kamienie milowe od M0 do S5) własnym wpisem o 26 liniach. Pozostało to niezauważone przez kilka dni, choć README nazywa ten plik „źródłem prawdy". Przywrócono z historii. - CI po asemblerze padało w dwóch miejscach. W trzech testach dymnych był wpisany rozmiar obrazu rozruchowego („10 MiB"), który przy większym jądrze urósł do 11 MiB; teraz nie zakładają rozmiaru. Drugą porażką był opisany wyżej test czasowy: za pierwszym razem wyglądało to na szum na współdzielonym runnerze, więc test powtarzaliśmy trzy razy; padł we wszystkich trzech próbach, i tak dowiedzieliśmy się, że to sygnał, a sygnałem okazał się nasz własny test (podpisywał za każdym razem tę samą wiadomość). Tę jedną granicę podnieśliśmy na kilka godzin, powiedzieliśmy o tym otwarcie i obniżyliśmy ją z powrotem, gdy przyczyna została naprawiona.
- Dokumentacja liczy trzy słowa rozruchowe, a kod ma cztery (
diag-serve), a tabela kamieni milowych w README nadal pokazuje pracę ostatniego tygodnia jako planowaną. Oba punkty są na mapie drogowej jako pozycje do poprawienia.
Mapa drogowa, z pytaniami
Po raz pierwszy jest mapa drogowa: około 40 pozycji w trzech fazach (v0.4 utwardzenie i eksploatacja; protokół i sieć; skalowanie, więcej chmur i bare metal), każda z uzasadnieniem wziętym z dokumentu, nakładem pracy, ryzykiem i sposobem weryfikacji, 16 pytań, na które może odpowiedzieć tylko właściciel, oraz lista tego, co jest poza zakresem. Kilka rzeczy mówi wprost: obsługiwane jest tylko MQTT 3.1.1, publikacja QoS 2 zamyka połączenie, nie ma IPv6 (dostawca daje /64), nie ma WebSocketu ani połączenia wychodzącego z brokera, a sterowników do urządzeń sieciowych i pamięci masowych dużych chmur nie ma.
Co nadal nie zostało udowodnione
- Koszt CPU na handshake z asemblerem zmierzono na rdzeniu Neoverse tylko raz (553 µs wobec 1,08 ms wcześniej, przy niższym zegarze, na współdzielonym hoście); 1,55 do 1,7 raza pochodzi z częstości pełnych handshaków, a 3 do 5 razy z rdzenia Apple. Strona x86_64 tego refaktoringu (kod przeniesiony do osobnego pliku) przeszła sprawdzenie typów i budowanie, ale jej testy jednostkowe nie były uruchamiane, a jądro x86_64 nie zostało po niej uruchomione: zestawy x86_64 nie są w CI, uruchamia się je ręcznie na Contabo VPS i dla tej zmiany jeszcze tego nie zrobiono.
- Stały czas: dla generowania klucza P-256, ECDH i podpisu (klucz i nonce) test statystyczny nie wykazał zależności od rzadkiego sekretu. Działał na rdzeniu Apple i na runnerze CI (maszynie wirtualnej Neoverse N2), nie na rdzeniu Neoverse N1 w netcup, i nigdy z ustawioną flagą DIT na rdzeniu serwerowym (A255-W2, otwarte: jądro jej nie ustawia). Nie działał dla X25519 ani Ed25519. Test czarnej skrzynki wyznacza granicę tylko tam, gdzie przy swoim rozmiarze próby potrafi rozróżniać.
- Jeden serwer, jeden dostawca, jedna instalacja. Kilka wyników (instalacja, utrata zasilania) to pojedyncze uruchomienie. Poza handshakami wiersze dotyczące wydajności nie mają „przed", a maszyna z dwoma vCPU daje brokerowi jeden rdzeń danych.
- Generator liczb losowych na tym serwerze jest zasiewany z jittera i z firmware, jak opisano wyżej.
- Klucz podpisujący jest nadal kluczem testowym, obrazy wydań to buildy deweloperskie, a tłumaczenia tego tekstu napisała AI i nie sprawdzili ich rodzimi użytkownicy języka.
- Brak niezależnego audytu, brak bare metal, brak IOMMU.
Co dalej
- X25519 w asemblerze dla ARM64 (to 176 µs z pozostałego handshaku) oraz powtórzenie pomiaru na handshake na rdzeniu Neoverse więcej niż raz.
- Decyzja o domyślnym ustawieniu generatora liczb losowych: odmawiać rozruchu bez źródła sprzętowego, chyba że operator postanowi inaczej, albo zachować rezerwę z jitterem i mówić o tym głośno.
- Stara lista: decyzja o D1, fuzzing parserów PCI i virtio, okno dialogowe klucza na stronie konstruktora.
- Z mapy drogowej, na następne wydanie: prawdziwy klucz podpisujący i produkcyjna PKI, MQTT 5.0 i QoS 2.
Kod jest na github.com/zeljan-alduk/urMQTT; docs/PROGRESS.md pozostaje źródłem prawdy o tym, co działa, docs/PERFORMANCE.md o tym, co zmierzono (sekcja 10 zawiera liczby dotyczące asemblera), docs/AUDIT.md o tym, co nie zostało udowodnione. Pre-alfa, jak dotąd; zgłoszenia błędów i zgłoszenia dotyczące bezpieczeństwa według instrukcji w SECURITY.md są mile widziane.
Aktualizacja, 4 listopada, później tego samego dnia. Cztery rzeczy z godzin po opublikowaniu tego tekstu.
- Brakująca liczba. Wpis diagnostyczny uruchomiono ponownie na serwerze netcup z asemblerem i dał liczbę, której brakuje w pierwszej tabeli: 553 µs CPU serwera na handshake z wzajemnym TLS wobec 1,08 ms wcześniej (szczegóły pod tą tabelą).
- Sygnał w podpisie był naszym testem. Przyczynę opisanego wyżej sygnału czasowego znaleziono i naprawiono w uprzęży testowej (podpisywała za każdym razem tę samą wiadomość); granica wróciła do 7. Otwarte pozostaje to, że flaga DIT nie jest ustawiana nigdzie (A255-W2).
-
Problem z ekranem jest rozwiązany i jest na
main. Napisaliśmy sterownik karty graficznej virtio (tylko 2D, ADR-256), włączany kluczem konfiguracji wpisanym w obraz (console.virtio_gpu, domyślnieoff, aautoionwymagają formatu konfiguracji 5). Zonzakładka Ekran u dostawcy pokazuje na żywo pulpit Diagnostyki na serwerze netcup, ten sam obraz co wyżej, łącznie z ostatnim ekranem z „press any key". Jego cel fuzzingu znalazł prawdziwy błąd w pierwszej wersji: odpowiedź z informacją o wyświetlaczu krótsza o cztery bajty niż w specyfikacji była przyjmowana jako poprawna (A256-W1); prawdziwe urządzenie zawsze wysyła całą odpowiedź, więc serwer nie był dotknięty, a parser teraz odrzuca krótką. Czego nie zweryfikowaliśmy: że ciemny wyświetlacz naprawdę wziął się z resetowania karty przez firmware przy przekazaniu jądru (prawdopodobne, niepotwierdzone), współdziałania z Secure Boot oraz x86_64 na prawdziwej maszynie (działało tylko pod emulacją). Znane ograniczenie (A256-W2): ustawienieautonie odróżnia działającego emulowanego framebuffera obok karty virtio od martwego, więc w tej jednej konfiguracji wybiera kartę virtio. Sterownik dodaje do jądra parser odpowiedzi hypervisora, dlatego jest wyłączony, jeśli konfiguracja o niego nie poprosi. -
Wydanie. Wszystko to jest w v0.4.0, opublikowanej tego samego wieczoru jako wersja wstępna (wydanie na GitHubie). Strona konstruktora na tej witrynie oferuje ją jako pierwszą; wymaga formatu konfiguracji 6, a starsze szablony (v0.2.0 do v0.3.0) odrzucają nowe klucze komunikatem, który każe użyć nowszego wydania. Ograniczenia v0.3.0 pozostają: klucz podpisujący jest nadal kluczem testowym, a obrazy to buildy deweloperskie z certyfikatami testowymi. CI na commicie wydania był zielony dopiero po ponownym uruchomieniu jednego zadania (test klienta wewnątrz scenariusza smoke raz przekroczył limit czasu, a za drugim razem przeszedł). Co sprawdziliśmy na opublikowanych plikach: podpis minisign, sumy kontrolne, atestacje budowania jądra i SBOM oraz szablon z nowymi kluczami (v0.4.0 je przyjmuje, v0.3.0 je odrzuca). Sterownik nowych urządzeń virtio (konsola, balon, wejście, vsock) jest w wydaniu, ale domyślnie wyłączony i nie był uruchamiany na prawdziwym serwerze.
Komentarze
Zasady komentowania