urMQTT num VPS real: ISO, handshake de 0,24 ms, disco próprio e kernel reforçado
O que aconteceu às três promessas do primeiro texto sobre o urMQTT (um único ISO, disco em bruto sem sistema de ficheiros, comprovadamente seguro) depois dos primeiros quatro dias de desenvolvimento, com medições, tabelas e uma lista do que ainda não está feito.
No primeiro texto sobre o urMQTT descrevemos um unikernel que é um broker MQTT, até ao marco M17, e terminámos com três promessas sob o título "O que se segue": um único ISO que arranca em várias plataformas, um disco em bruto sem sistema de ficheiros e uma segurança que se pode provar, e não apenas afirmar. Nada disso estava então construído. Este texto acompanha o que aconteceu a cada promessa, pela mesma ordem de antes: o que planeámos, o que construímos, o que nos surpreendeu e o que continua em aberto. Pelo caminho mostramos também quanto tempo isto demorou, porque faz parte da história.
Uma nota prévia: o projeto continua pré-alfa. Os números do texto medem código e testes, não maturidade em produção, e a primeira versão está deliberadamente limitada a VPS com KVM. O bare metal fica para mais tarde.
Como isto se desenrolou no tempo
O primeiro commit foi feito a 28 de outubro de 2026 às 23:48 (M0). A 31 de outubro às 23:00 o repositório tem 119 commits, distribuídos como 3, 39, 38 e 39 por dia de calendário. Digamos já como isso é possível: o projeto é construído com o Claude Code, e os commits trazem trailers Co-Authored-By: Claude. Quatro dias de calendário de histórico não significam que uma pessoa tenha escrito 90 000 linhas em quatro dias; significam que o plano, a implementação, os testes e os ADR são escritos em ciclos curtos e fechados, e que cada passo termina com o mesmo ritual de verificação de antes. Os números abaixo falam da quantidade de código e de testes, não de quanto de tudo isto foi validado em trabalho real.
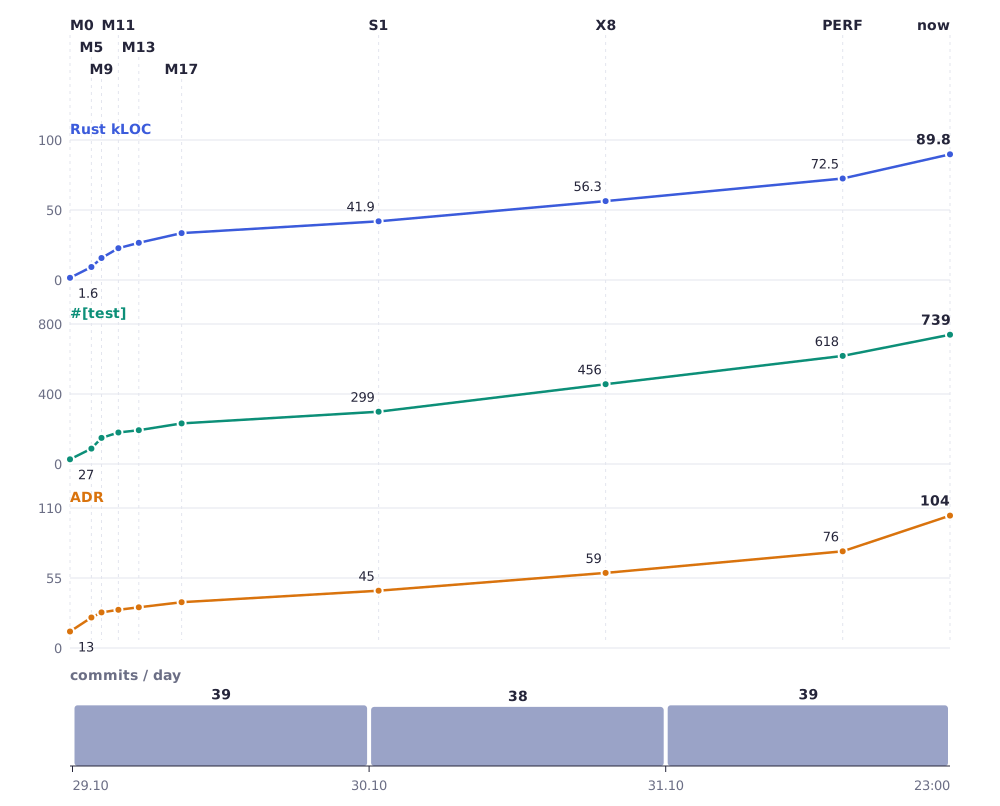
O gráfico mostra três curvas que crescem quase em conjunto, o que é intencional: os testes e as decisões registadas acompanham o código, em vez de ficarem para trás. A inclinação é maior a 29 de outubro, quando nasce todo o caminho do kernel até ao broker. Depois as linhas acrescentam-se mais devagar, mas os testes crescem mais depressa do que o código (27 testes para 1,6 mil linhas no início, 739 para 89,8 mil hoje).
| Marco | Commit | Hora | Linhas de Rust | Testes | ADR |
|---|---|---|---|---|---|
| M0 | 9412a9c | 28.10. 23:48 | 1 592 | 27 | 13 |
| M5 | a61083b | 29.10. 01:32 | 9 314 | 88 | 24 |
| M9 | 4be8cc9 | 29.10. 02:21 | 15 729 | 149 | 28 |
| M11 | 4800904 | 29.10. 03:43 | 22 737 | 180 | 30 |
| M13 | a558d5e | 29.10. 05:22 | 26 556 | 193 | 32 |
| M17 | 7df4f98 | 29.10. 08:48 | 33 504 | 232 | 36 |
| S1 | ecf72ec | 30.10. 00:46 | 41 910 | 299 | 45 |
| X8 | fb1504a | 30.10. 19:08 | 56 341 | 456 | 59 |
| PERF | 76f7c36 | 31.10. 14:19 | 72 511 | 618 | 76 |
| hoje | HEAD | 31.10. 23:00 | 89 790 | 739 | 104 |
As linhas são todos os ficheiros .rs fora de vendor/ e fuzz/, e os testes são funções #[test]. O que cada fase acrescentou, segundo as datas do histórico do git:
| Data | Marcos | O que foi acrescentado |
|---|---|---|
| 29.10. | M0 a M17 | kernel, rede, TLS, broker, SQLite, vários núcleos, TCP próprio, reforço, versão reprodutível |
| 29.10. à noite e 30.10. | X0 a X10, S1, H2, H3 (o X0 começa a 29.10. às 20:54) | port para x86_64, ISO universal, um só disco e ISO de autoinstalação, verificações de TLS, clientes atacantes |
| 31.10. | O1 a O4, T1, PERF, H4, H5, H9, S2 a S6 | observabilidade e consola através de MQTT, modo live e diagnóstico, SNTP, acelerações, reforço, verificação, cadeia de abastecimento, armazenamento |
Promessa 1: um ISO para várias plataformas
O que planeámos. Um único ficheiro que arranca em UEFI aarch64, UEFI x86_64 e BIOS x86_64. O que construímos. O port para x86_64 (X0 a X10) e um ISO universal com o bootloader Limine, um ISO híbrido a partir do qual arrancam todas essas combinações; os smoke tests arrancam-no em quatro máquinas virtuais. O menu tem três entradas: urMQTT (modo live, corre a partir da RAM, não escreve nada no disco), instalação no disco da máquina em que está a correr (a instalação escreve o GPT e os dados e depois desliga a máquina) e Diagnóstico (deteção de hardware e medições).
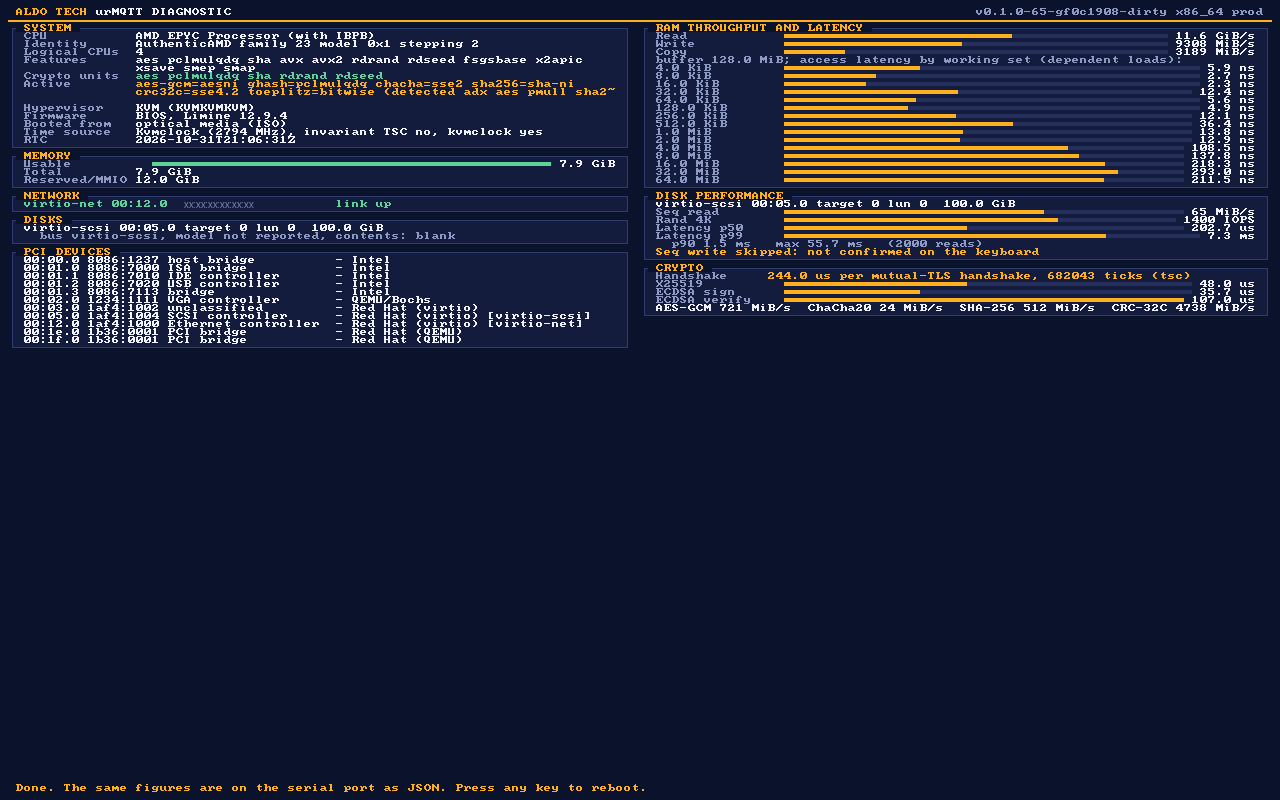
O primeiro alvo real foi um VPS, e não um computador físico: a decisão é que a primeira versão suporte apenas VPS (KVM), e o bare metal vem depois. Testámos num VPS da Contabo com um processador AMD EPYC (família 23, Zen 1), 4 vCPU e 8 GiB de RAM, com rede virtio-net e disco virtio-scsi. A primeira tentativa surpreendeu-nos: o ISO ligado como CD virtual arrancava a entrada predefinida, a imagem de produção recusava-se a servir a partir de um suporte só de leitura e reiniciava, e ficámos com um ciclo infinito de menu, kernel, reinício sem nada legível. Hoje, um erro fatal na imagem de produção deixa uma mensagem na consola durante 60 segundos antes de reiniciar e, a partir de um suporte ótico, escreve que arrancou de um suporte só de leitura e pára. O modo live em RAM (O3) contornou depois esse problema para o caso habitual.
A entrada de diagnóstico nasceu dessa experiência: uma máquina que não vemos tem de poder ser interrogada sobre o que tem. Mostra CPU, RAM, rede, discos e dispositivos PCI, mede a largura de banda da memória, o disco e a criptografia, e escreve as mesmas medições em JSON na porta série. A escrita no disco só é permitida no espaço não atribuído e apenas depois de se escrever WIPE; na captura abaixo isso foi ignorado.
O que fica em aberto. Hardware real. Depois da primeira versão segue-se o bare metal (arranque por USB, NVMe e AHCI, a placa de rede de um computador verdadeiro), juntamente com IOMMU e Secure Boot, porque sem IOMMU um dispositivo malicioso ou avariado pode escrever em toda a memória. Nesta versão não afirmamos nada sobre isso.
O handshake: de 1,2 ms para 0,24 ms
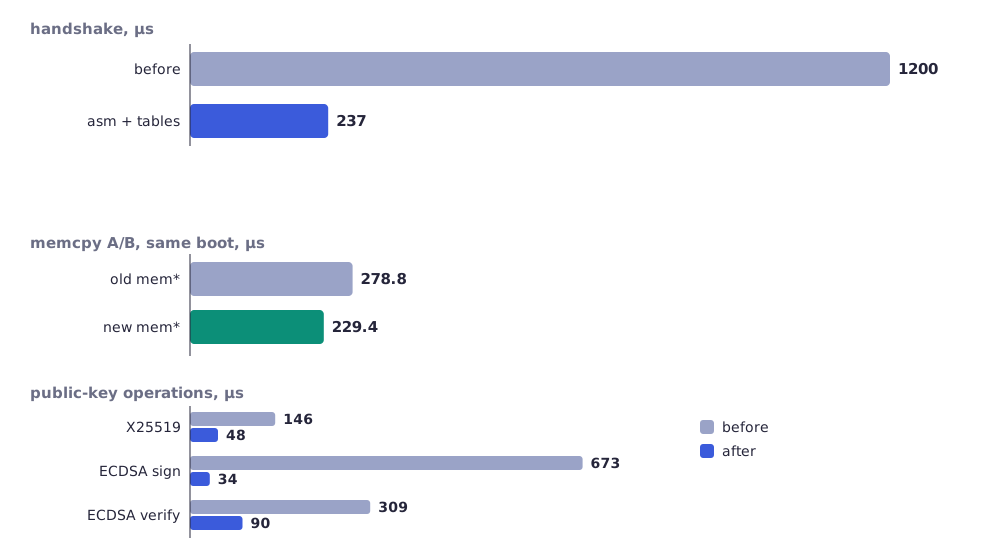
A primeira medição do diagnóstico no VPS deu um número incómodo: o handshake mTLS, apenas a criptografia do lado do servidor, demorava 1,2 ms. No aarch64 já usávamos as instruções de hardware AES e SHA, mas o x86_64 não tinha nada de semelhante para a chave pública: o RustCrypto é portável e constant-time, e por isso também lento. Três alterações baixaram esse valor.
- Para o P-256 adotámos o assembly
nistz256do OpenSSL e do ring (ADR-130), com tabelas de base fixa para a assinatura e para a verificação de assinaturas da CA (ADR-110, ADR-111). - O X25519 foi reescrito com quatro membros de 64 bits e instruções MULX/ADX (ADR-131).
- Depois disso, perfilámos o resto (ADR-132, ADR-200).
| Medição no VPS (servidor, microssegundos) | Antes | Depois |
|---|---|---|
| handshake mTLS, toda a criptografia | 1200 | cerca de 240 (237 na medição do gráfico, 244 na captura) |
| X25519 | 146 | 48 |
| assinatura ECDSA | 673 | 34 |
| verificação ECDSA | 309 | 90 (107 na captura) |
| handshake, memcpy antigo, mesmo boot | 278,8 | 229,4 (-17,7%) |
Os números variam cerca de 10% de execução para execução, por isso registámos um intervalo em vez de um único valor. No total, isto representa aproximadamente cinco vezes menos tempo de CPU por handshake.
O que aprendemos sobre o memcpy. Quando a criptografia baixou, o perfil mostrou algo que não esperávamos: as funções mem* (memcpy, memmove, memset) consumiam 7% do handshake, 13 a 39% do caminho de um registo TLS (39% para 64 B, 13% para 4 KiB) e 17 a 34% da distribuição de um PUBLISH. Substituímo-las por assembly SSE2 para x86_64 (ADR-200), com testes diferenciais face à implementação de referência para todos os tamanhos, alinhamentos e sobreposições. Por chamada, são 55 a 75 ciclos contra 7 a 12 para 1 a 64 bytes.
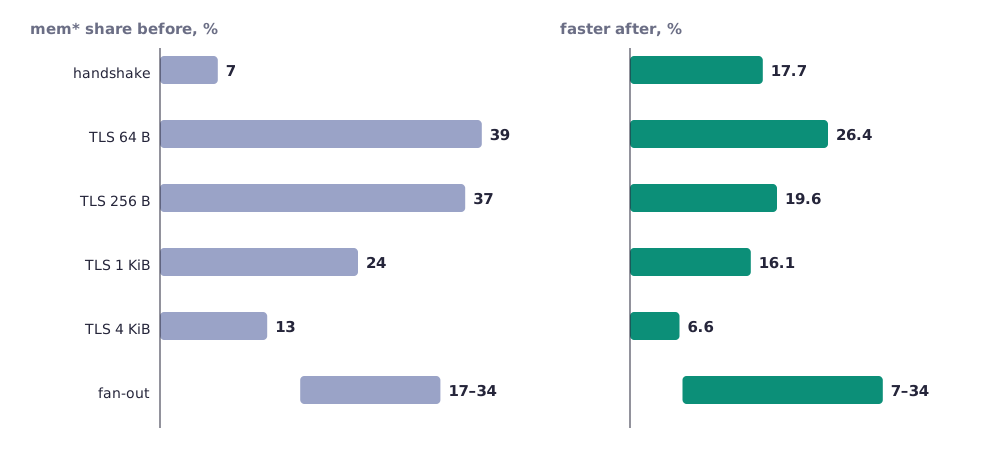
| Caminho | Parte de mem* antes | Mais rápido depois |
|---|---|---|
| handshake | 7% | 17,7% |
| registo TLS de 64 B | 39% | 26,4% |
| registo TLS de 256 B | 37% | 19,6% |
| registo TLS de 1 KiB | 24% | 16,1% |
| registo TLS de 4 KiB | 13% | 6,6% |
| distribuição de mensagens | 17 a 34% | 7 a 34% |
Como ler o gráfico: quanto mais pequeno é o registo, maior é a parte do tempo que vai para a cópia, e por isso maior é o ganho. Para mensagens pequenas, que são a maioria do tráfego MQTT, é isto que conta.
O que isto não significa. Em x86_64 nativo medimos o OpenSSL 3.5.5 apenas como referência para o assembly (ADR-130), e não como comparação de produtos. A comparação Linux mais Mosquitto no mesmo VPS (tarefa X11) ainda não foi feita. Por isso não afirmamos que o urMQTT é mais rápido do que o Linux: não foi medido. Os números acima comparam o urMQTT consigo próprio.
A sobrecarga foi o segundo resultado. No VPS, a partir de um Mac (RTT de 35 ms), 128 clientes deram 618 handshakes por segundo, 256 clientes deram 393 e 512 clientes deram 67, com milhares de ligações recusadas. Não foi um patamar, foi um colapso. Encontrámos as causas no código (duas foram confirmadas no QEMU/HVF e não puderam ser reproduzidas no VPS), várias em simultâneo: uma ligação recusada devolvia o cliente pelo segmento seguinte que traz um SYN cookie válido, a recusa por RST dizia ao cliente para tentar de novo de imediato, e a receção era O(fila). A correção (ADR-080 a ADR-082) descarta o SYN que não seria aceite, memoriza os fluxos recusados, mantém a receção em O(1) e conta os handshakes por núcleo. É possível (hipótese, não verificada) que parte da causa estivesse também no cliente: a ferramenta de carga fechava primeiro, pelo que um Mac com 16 384 portos efémeros e um TIME_WAIT de 30 segundos ficava limitado a cerca de 550 ligações por segundo. Por isso ainda não medimos o verdadeiro teto do servidor.
Promessa 2: disco em bruto, mas cuidadoso
O que planeámos. Manter a disposição própria sem sistema de ficheiros e acrescentar tudo o que um sistema de ficheiros normalmente dá: alinhamento, crescimento, discard, cópias de segurança e verificações. Porque não um sistema de ficheiros. Discutimos o assunto e a decisão foi confirmada: o urMQTT escreve uma base de dados, um diário de telemetria e os seus próprios metadados, não precisa de diretórios, permissões nem nomes de ficheiros, e cada camada adicional seria mais código na parte de confiança e mais uma forma de uma escrita desaparecer em silêncio. O disco é GPT, com uma partição ESP e uma partição de dados do urMQTT, na qual está a disposição própria.
O que construímos (S2 a S6).
- Disposição v2 (S2). Topologia do disco, alinhamento a 1 MiB ou ao tamanho ótimo de I/O, blocos físicos inteiros, par A/B de superblocos com geração (ADR-140). A disposição v1 é recusada pelo kernel com uma mensagem clara e migrada pela ferramenta offline
urmqtt-disk migrate(ADR-141): por omissão é uma passagem de ensaio, copia-se e só depois se comuta, com reversão e injeção de falhas em cada escrita. - Crescimento (S3). No arranque o disco pode crescer (nunca encolhe) e, em virtio-blk, também durante a execução, através da interrupção de alteração de configuração (ADR-142, ADR-143).
- Discard e write-zeroes (S4). Os discos de provisionamento dinâmico devolvem o espaço ao anfitrião. Num teste, o ficheiro qcow2 no anfitrião desceu de 62 para 16 MiB depois de expirarem os segmentos de telemetria, e a recuperação nunca confia no conteúdo que foi descartado.
- Cópia de segurança da base de dados no disco (S5). Uma cópia A/B com a API de backup online do SQLite em passos de 16 páginas: o passo mais longo é de 4,6 ms contra 445 ms quando se copia numa única chamada. Os commits durante a cópia tiveram um máximo de 2,4 ms contra 2,2 ms sem ela. Se o
quick_checkfalhar no arranque, a base de dados é restaurada a partir da cópia. - Limpeza e arranque limitado (S6). O scrubber lê o disco com um orçamento de I/O limitado e comunica os registos danificados, e o arranque lê apenas o segmento mais recente de cada partição, de modo que o tempo de arranque não cresce com o tamanho da região de telemetria. Fechámos assim um problema que tínhamos calculado de antemão: num disco grande, a recuperação completa demoraria de minutos a dezenas de minutos.
Todo o grupo de smoke tests de armazenamento passa nas duas arquiteturas: 79 com sucesso, 0 falhados, em aarch64 sob HVF e em x86_64 sob TCG. Medimos também que o S4 não tornou a base de dados mais lenta: 53,3 mil inserções por segundo em lotes antes e depois, sem diferença mensurável.
O que surpreendeu. Quanto de uma disposição "simples" se vai em casos limite: virtio-scsi e virtio-blk comunicam a topologia de formas diferentes, e uma escrita incompleta a meio de uma migração tem de deixar sempre pelo menos uma versão válida. Por isso cada escrita no caminho da migração e do crescimento passou por injeção de falhas.
O que fica em aberto. As páginas do SQLite não têm checksum, pelo que a base de dados não deteta um bit alterado dentro do valor de uma linha; os registos de telemetria e o conteúdo das cópias têm CRC e são detetados. A cifragem do disco (S7) não está feita.
Promessa 3: comprovadamente seguro, tanto quanto conseguirmos
Reforço (H4). O alocador apaga a memória libertada e verifica-a na reutilização, deteta a dupla libertação, liga os ponteiros da lista livre com XOR e zera as chaves ao libertar (ADR-170). Proteção da pilha (-Zstack-protector=strong, 1315 funções, e o SQLite com -fstack-protector-strong, ADR-171). Os relatórios de erro em produção não contêm registos nem endereços (ADR-172). KASLR nas duas arquiteturas: o kernel é PIE e o Limine desloca-o cerca de 19 bits, e o heap, as pilhas e a janela MMIO são colocados aleatoriamente (ADR-173). No aarch64 o MTE marca o heap (ADR-174), mas só sob TCG: o HVF e o x86 não o têm. O kCFI foi avaliado e não o adotámos porque o compilador no nightly fixado falha com um erro interno; o IOMMU foi adiado juntamente com o bare metal (ADR-175, ADR-176).
O custo foi medido, não presumido. No caminho do handshake (dp-bench, aarch64 HVF, handshakes completos TLS 1.3 + mTLS + CONNECT):
| Passo | 1 núcleo | 4 núcleos | Variação |
|---|---|---|---|
| sem reforço | 1941 | 7620 | |
| + alocador | 1898 | 7429 | -2,2% a -2,5% |
| + proteção da pilha | 1845 | 7243 | em conjunto -4,9% a -5% |
| + PIE e marcas | cerca de 1800 | cerca de 6750 | num computador carregado, com ruído |
No total, o custo no caminho do handshake é portanto de cerca de 5% para as partes medidas de forma limpa e, com PIE e marcas, sai cerca de 7% com um núcleo e cerca de 11% com quatro, mas esta medição tem ruído. Consideramo-lo aceitável, mas não o repetimos no VPS x86_64.
Vale a pena comparar com o número do primeiro texto (862 handshakes por segundo num núcleo). A mesma ferramenta hoje, com o controlador de cifragem por hardware no aarch64 (X0b) e uma série de acelerações que chegaram desde então, dá 1941 antes do reforço. Não isolámos a contribuição de cada alteração, por isso não afirmamos nada sobre a causa.
Como foi verificado, e o que não foi. O H5 acrescentou o Miri a um subconjunto de crates do host, provas Kani, sanitizers, um model-fuzzer para a ACL e relatórios de cobertura. O Kani provou o record_len no TLS, o parse no TCP e duas aritméticas da roda de temporizadores. Não está provado (tempo esgotado): os dois descodificadores MQTT, os dois parsings de configuração e o comportamento da roda de temporizadores; por isso o trabalho de CI do Kani ainda não é bloqueante. O Miri não consegue executar assembly. Cadeia de abastecimento (H9): SBOM CycloneDX com 215 componentes, o cargo-vet passa com 39 totalmente auditados e 140 exceções, e o cargo-deny está configurado para tratar os avisos de vulnerabilidades como falha da CI (esses trabalhos de CI foram até agora verificados só localmente, não no GitHub, e o teste negativo não foi executado), juntamente com o VULNERABILITY-HANDLING.md. O estado honesto: das 67 versões de crates de terceiros ligadas ao kernel, 53 são exceções e não auditorias. O vet prova que o conjunto de dependências não pode mudar sem uma diferença visível, não que o TCB tenha sido revisto. Não escrevemos uma auditoria nossa para nenhum crate.
O SNTP (T1) é, nesse sentido, uma pequena história de segurança: é opcional, apenas para servidores IPv4 privados, com um salto máximo e a condição de as fontes concordarem (mediana, maioria dentro de um segundo). Um relógio que qualquer pessoa no caminho pode deslocar não é um relógio em que possamos confiar para a validade dos certificados.
No Mac: aarch64 nativo e x86_64 por emulação
Desenvolvemos num Mac, e este tem duas formas de executar o mesmo código, muito diferentes entre si.
| aarch64 sob HVF | x86_64 sob TCG | |
|---|---|---|
| O que é | execução nativa, velocidade próxima da de um processador real | o QEMU emula as instruções |
| Handshake no convidado | cerca de 0,58 ms (medido pela primeira vez por volta do M13); dp-bench hoje 1941/s por núcleo |
cerca de 3,3 ms |
| Cenários de smoke TLS | rápidos | cerca de 15 minutos por cenário |
| MTE | não (não existe no HVF) | o x86 não o tem; a marcação do heap só funciona para um convidado aarch64 sob TCG |
| Para que serve | medições reais | correção: o caminho x86 é verificado, os números não são desempenho |
A regra é simples: os números sob TCG são emulação e não os citamos como desempenho. O desempenho em x86 só o medimos num VPS real. Por isso os números de criptografia acima vêm do VPS da Contabo, e não do Mac.
Lições
- Meçam numa máquina real antes de otimizar. A primeira abordagem foi otimizar o que pensávamos ser lento; só o diagnóstico no VPS mostrou os 1,2 ms e onde exatamente o tempo se perde.
- A sobrecarga é uma funcionalidade à parte. Um sistema rápido sob carga pode colapsar acima dela; recusar tem de ser mais barato do que aceitar.
- O perfil surpreende. O maior ganho individual para mensagens pequenas não esteve na criptografia, mas na cópia de memória.
- Um disco sem sistema de ficheiros dá mais trabalho, não menos. O que o sistema de ficheiros normalmente dá (alinhamento, crescimento, discard, cópias, verificações) temos de o escrever e verificar nós, cada passo com injeção de falhas.
- Honestidade nos números. As medições de memória num VPS partilhado variam até 10 vezes entre execuções e não dizem nada sobre o código, por isso não as citamos. Os números de criptografia são estáveis até cerca de 10%.
- A velocidade de desenvolvimento não é maturidade. Os testes e os ADR crescem com o código, mas quatro dias não são operação a sério.
O que se segue
- H6: SQLite isolado ao nível EL0, para que um erro na base de dados não abra o kernel.
- H7: o resto da segurança do tempo (NTS e tratamento de saltos); o SNTP é apenas o primeiro passo.
- X11: comparação com o Linux e o Mosquitto no mesmo VPS, só então faz sentido falar de velocidade relativa.
- Versão: a primeira publicação pública para VPS (KVM), com artefactos assinados e instruções.
- Depois da versão: bare metal (X12 a X16), IOMMU e Secure Boot, e a cifragem do disco.
O código está em github.com/zeljan-alduk/urMQTT, e o docs/PROGRESS.md continua a ser a única fonte de verdade sobre o que realmente funciona. Pré-alfa, como antes; relatórios de erros e comunicações de segurança, seguindo as instruções em SECURITY.md, são bem-vindos.
Comentários
Regras dos comentários