urMQTT: costruiamo un broker MQTT che è anche un sistema operativo
Note di sviluppo su urMQTT, un unikernel scritto in Rust che è esso stesso un broker MQTT: un unico ELF con TCP/IP, TLS 1.3, broker e SQLite propri, avviato da un solo ISO.
I dispositivi installati nei veicoli, nei parcheggi e negli armadi elettrici hanno una caratteristica in comune: inviano messaggi piccoli, di rado, ma sono molti e restano sempre connessi. Da anni li colleghiamo a broker MQTT, e da anni ci poniamo la stessa domanda. Perché per una cosa così semplice servono un intero Linux, OpenSSL, il runtime di un linguaggio, SSH, un gestore di pacchetti e solo alla fine il broker? Ciascuno di questi strati porta con sé le proprie vulnerabilità, consuma la propria memoria e aggiunge un altro elemento che può guastarsi, mentre una flotta di dispositivi chiede al server soltanto tre cose: mantenere molte connessioni quasi inattive, autenticare ogni dispositivo in modo affidabile e trasportare i messaggi senza perderli.
Così è nato urMQTT: un unikernel che è un broker MQTT. Kernel, TCP/IP, TLS 1.3, MQTT e un database integrato in un unico programma binario Rust che si avvia da un solo ISO. Nessun processo, nessuna chiamata di sistema, nessuna shell. La prima piattaforma su cui viene costruito e collaudato è aarch64, e lo stesso codice è in cammino verso x86_64, tramite UEFI e BIOS classico, e verso l'hardware reale: l'obiettivo è un solo ISO che si avvii su tutti. Il progetto è open source con licenza MIT o Apache 2.0, e in questo articolo vogliamo mettere per iscritto a che punto siamo, com'è fatto al suo interno e che cosa abbiamo imparato lungo la strada.
Che cosa significa esattamente "unikernel"
Un broker tradizionale è un programma che gira su un sistema operativo. urMQTT non ha alcun sistema operativo sotto di sé: si avvia da solo attraverso il firmware UEFI e il bootloader Limine, imposta le proprie tabelle delle pagine, programma il controller degli interrupt e il timer, individua i dispositivi virtio tramite PCIe, ottiene un indirizzo via DHCP e ascolta su una sola porta. Tutto ciò che di solito fanno kernel, driver, stack di rete e applicazione, qui è un unico ELF eseguito a livello EL1.
Il confronto con un'installazione tipica parla da sé:
| Broker tipico su Linux | urMQTT | |
|---|---|---|
| Servizi esposti | SSH, broker, spesso anche una porta per metriche o amministrazione | solo TCP 8883 (MQTT su TLS 1.3 con mTLS) |
| Codice nell'immagine | kernel, userland, libc, OpenSSL, runtime | un solo ELF Rust (più SQLite incluso nel repository) |
| Gestione remota | shell, file di configurazione, aggiornamenti dei pacchetti | nessuna. Una nuova versione è un nuovo ISO |
| Memoria per connessione inattiva | kilobyte (buffer dei socket, oggetti TLS, heap) | obiettivo ≤ 512 B |
| Modello multicore | thread e lock oppure un unico event loop | un thread per core, nessuno stato condiviso, elaborazione completa sullo stesso core |
| Integrità del codice | sono possibili mappature contemporaneamente scrivibili ed eseguibili | W^X, tabelle delle pagine bloccate, PAC/BTI |
Le priorità sono, in quest'ordine: sicurezza, scalabilità, prestazioni multicore, ingombro ridotto e installazione immutabile. Quando due obiettivi entrano in conflitto, prevale quello che sta più in alto nell'elenco.
A che punto siamo
Il progetto è in fase pre-alfa, ma sono state chiuse diciassette milestone di sviluppo, da M0 a M17. Oggi urMQTT serve MQTT 3.1.1 su TLS 1.3 con certificati client obbligatori e conserva lo stato in SQLite su disco raw. In breve, ciò che già funziona:
- Kernel: vettori di eccezione propri con report decodificati, tabelle delle pagine proprie con W^X applicato, pagine di guardia, PAC e BTI dove il processore li supporta, GICv3 e GICv2, timer generico, SMP fino a 64 core.
- Rilevamento dell'hardware da DTB o ACPI in un'unica descrizione della piattaforma, con risultato identico da entrambe le fonti.
- Driver: PCIe ECAM, MSI-X, virtio-net, virtio-blk, virtio-scsi e virtio-rng, più un CSPRNG inizializzato con entropia hardware.
- Rete: DHCPv4, ARP, ICMP e IPv4 rigoroso, tutti propri, e poi un TCP proprio solo lato server: SYN cookie, timer wheel gerarchica, NewReno, coalescenza degli ACK, nessuno stato TIME_WAIT.
- TLS: solo TLS 1.3, mTLS obbligatorio, identità del dispositivo ricavata dal CN o dal SAN URI; l'handshake è gestito da rustls, dopodiché subentra un livello di record proprio con AES-128-GCM e ChaCha20-Poly1305. Ripresa della sessione con ticket PSK, lista di revoca, controllo di ammissione già in fase di handshake.
- MQTT: codec zero-copy, sottoposto a fuzzing e testato con veri client mosquitto; QoS 0 e 1, wildcard, messaggi retained, last will (LWT), sessioni persistenti, ACL limitate a
devices/{id}/#, limiti di frequenza per dispositivo. - Archiviazione: SQLite dentro il kernel tramite un VFS su disco raw, in modalità WAL, con verifica dell'integrità all'avvio; registro dei dispositivi, revoche, messaggi retained, sessioni persistenti con code di messaggi per i dispositivi offline; per ogni core un log di telemetria separato con CRC per record e ripristino dopo un crash.
- Esercizio e sorveglianza: timer watchdog per i gestori, health check, logging limitato, syslog e statsd su UDP, un'ammissione che resiste alle tempeste di riconnessioni.
- Distribuzione: build ripetute bit per bit e verificate in CI, ISO e immagine disco GPT raw, firme minisign, istruzioni per KVM, Proxmox e Hetzner.
Ogni passo è contrassegnato dalla milestone che lo ha portato, e il file docs/PROGRESS.md nel repository è l'unica fonte di verità su ciò che funziona davvero.
L'architettura in tre immagini
L'intera progettazione è descritta in docs/ARCHITECTURE.md, mentre le ragioni di ogni decisione importante sono registrate come ADR in docs/DECISIONS.md. Ecco una panoramica.
Gli strati
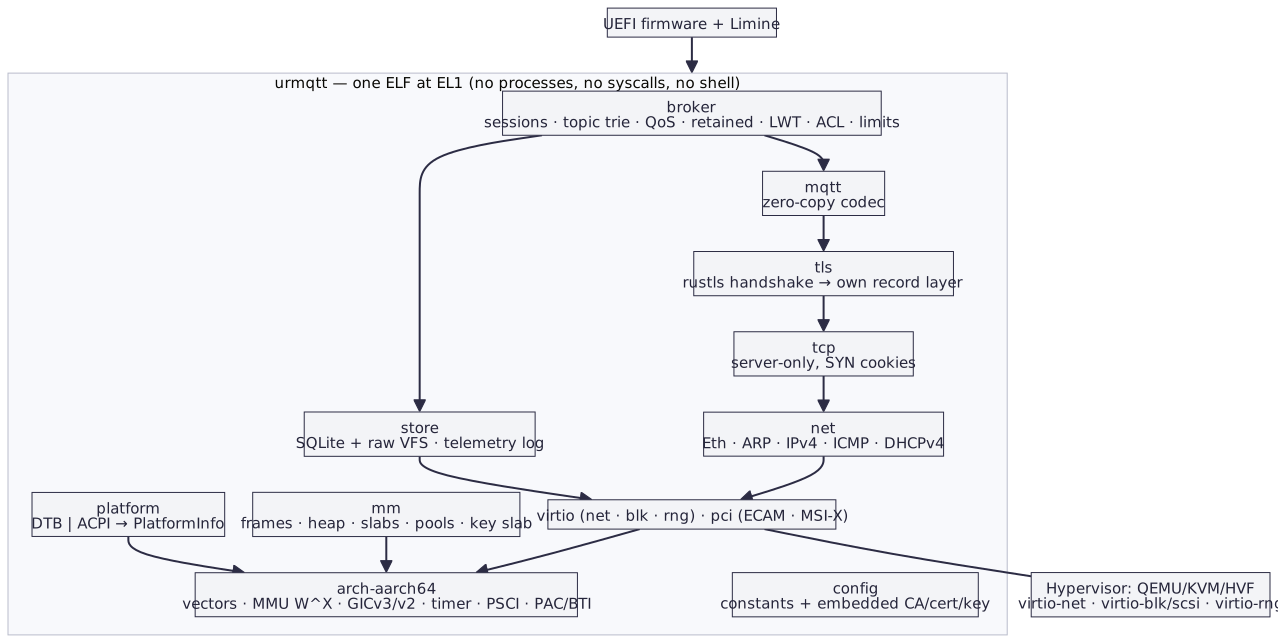
Dall'alto verso il basso: il broker (sessioni, albero dei topic, QoS, messaggi retained, will, ACL, limiti), il codec MQTT, TLS, TCP, lo strato di rete e infine i driver. Accanto a questo percorso principale si trova l'archiviazione (SQLite e log di telemetria), e sotto a tutto la gestione della memoria, il rilevamento della piattaforma e la configurazione, compilata in costanti al momento della build, insieme al certificato CA, al certificato del server e alla chiave incorporati. L'hypervisor con i dispositivi virtio è l'unica cosa che resta fuori dall'immagine.
Un thread per core, nessuno stato condiviso
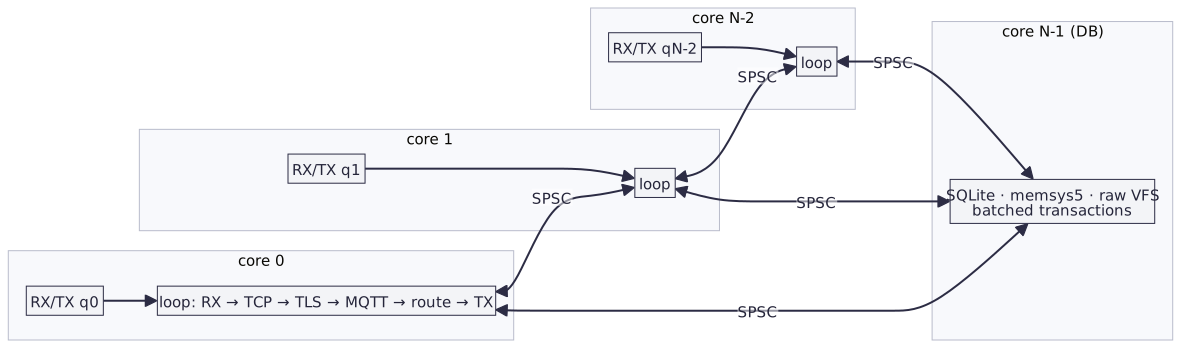
Ogni core dati esegue un proprio ciclo con il proprio stack TCP, i propri stati TLS, una porzione del broker (sessioni e albero dei topic), la cache dell'heap e la partizione di telemetria. I core non condividono alcuno stato mutabile, ma soltanto anelli limitati e privi di lock, uno per ogni coppia ordinata di core. Il core con il numero più alto esegue SQLite e nient'altro.
La scheda di rete ha oggi una sola coppia di code, gestita dal core 0. Questo smista ogni flusso MQTT su uno dei core di lavoro in base all'hash Toeplitz della sua quadrupla e invia ciò che i core di lavoro restituiscono. Una sessione vive sul proprio core di appartenenza, determinato dall'hash dell'identificatore del client, così che take-over, will e persistenza non attraversino mai i core. Una connessione che atterra su un altro core vi mantiene il proprio TCP e TLS, ma inoltra l'MQTT in chiaro al core di appartenenza con un controllo di flusso basato su crediti. Ogni messaggio instradato viene inoltre distribuito alle altre porzioni del broker, ciascuna delle quali tiene una replica dei messaggi retained.
Tre regole tengono insieme questo modello. Elaborazione completa sullo stesso core: un pacchetto ricevuto viene elaborato per intero su un solo core, dal TCP alla decifratura TLS sul posto, dal parsing MQTT all'instradamento fino alla risposta cifrata, senza code di task e senza copie nei buffer applicativi. Polling adattivo: sotto carico le code di ricezione vengono interrogate attivamente, mentre a riposo il core torna agli interrupt e a WFI; i gestori degli interrupt si limitano a confermare l'interrupt e a segnalare il lavoro. Watchdog: un tick da 10 ms per core intercetta i gestori che superano il proprio budget.
La vita di un PUBLISH
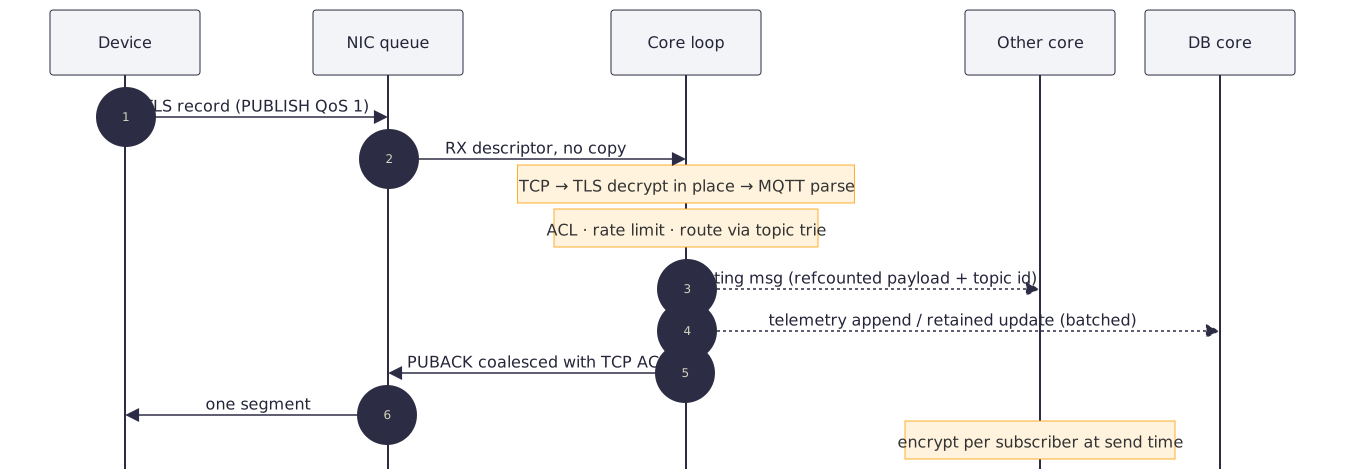
Il dispositivo invia un record TLS. La scheda di rete lo consegna al ciclo del core tramite un descrittore, senza copie. Il ciclo verifica il TCP, decifra il TLS sul posto e analizza l'MQTT da un buffer preso in prestito, poi controlla in memoria l'ACL, il limite di frequenza e il percorso nell'albero dei topic. Se un altro core è interessato a quel topic, riceve un messaggio di instradamento con il riferimento al payload e l'identificatore del topic; il database riceve un record di telemetria o l'aggiornamento di un messaggio retained, in batch. La risposta PUBACK viene cifrata direttamente nel buffer in uscita e unita al TCP ACK, così al dispositivo parte un solo segmento. Per l'altro core il messaggio costa una cifratura per sottoscrittore al momento dell'invio.
Quanto costa una connessione
L'obiettivo è al massimo 512 byte per connessione TLS inattiva, con la tensione verso i 256. Finché la connessione è a riposo, per essa non viene trattenuto alcun buffer: i dati ricevuti vengono elaborati direttamente dal frame di rete, e i buffer per invio, record e MQTT esistono solo finché qualcosa è incompleto o non confermato. Il kernel misura da sé anche questo: contatori esatti dell'heap, in byte richiesti e in blocchi occupati, registrati ogni dieci secondi come heap oltre il livello di base per connessione aperta.
| Componente | Dimensione | Come |
|---|---|---|
| Blocco di controllo TCP | 96 B | flag compattati, RTT/RTO a 16 bit, slot nella timer wheel, nessun buffer a riposo |
| Slot nella tabella TCP | 4–8 B | solo l'indice della connessione, tabella piena al massimo a metà |
| Connessione e stato dei record TLS 1.3 | 152 B | segreto e sequenza per direzione (40 B); chiave e IV derivati per record |
| Connessione MQTT | 48 B | identità e will sull'heap solo finché esistono |
| Sessione MQTT, forma hot | 64 B | una sottoscrizione in linea, identificatori dei nodi internati |
Sottoscrizione devices/<id>/cmd/# |
0 nodi dell'albero | memorizzata in forma relativa all'identificatore di sessione, condivisa da tutti i dispositivi |
Misurato sotto HVF con quattro core virtuali, di cui tre di lavoro, con ogni dispositivo che mantiene una connessione mTLS e una sottoscrizione QoS 1, compreso l'arrotondamento dell'allocatore:
| Connessioni | Byte per connessione |
|---|---|
| 960 | 531 B |
| 9 922 | 494 B |
| 10 197 | 474 B |
Il pool dei frame di rete è fisso, di circa 2 MiB, ovvero circa 200 B per connessione con diecimila connessioni e circa 2 B con un milione. Oltre questo non siamo riusciti a misurare: il networking utente di QEMU su macOS ha smesso di accettare connessioni a 10 197, più o meno al limite di 10 240 descrittori del processo QEMU. La cifra scende man mano che le parti fisse si ripartiscono su più connessioni, quindi non cresce con il loro numero.
Il modello di sicurezza
La sicurezza è la prima priorità e vince tutti i conflitti con gli altri obiettivi. Il modello è composto da più strati:
- Una sola porta. TCP 8883, solo TLS 1.3, certificati client obbligatori firmati dalla CA incorporata nell'immagine. L'identificatore del client MQTT deve coincidere con l'identificatore del dispositivo presente nel certificato.
- Nessun punto d'ingresso. Nessuna shell, nessun input da console, nessun SSH, nessuna API di amministrazione, nessun codice dinamico, nessun SQL raggiungibile dalla rete e nessun file system.
- Sicurezza della memoria. Rust, con
forbid(unsafe_code)nei crate di protocollo; ogni bloccounsafeha un commento// SAFETY:verificato da un lint, e sull'input esterno non ci sono panic: clippy nei crate del percorso dati vietaunwrap,expect, l'indicizzazione epanic!. - Mitigazione dello sfruttamento. W^X è applicato tramite la codifica dei descrittori e il bit
SCTLR_EL1.WXN, e viene riverificato a ogni avvio. Dopo l'avvio le tabelle delle pagine sono di sola lettura, senza alias scrivibili. La metà inferiore dello spazio di indirizzamento è esclusa. Ogni stack ha pagine di guardia e le eccezioni girano su uno stack separato. PAC e BTI si attivano quando il processore li supporta, e lo verificano gli smoke test. - Resistenza agli abusi. SYN cookie; l'ammissione rifiuta le nuove connessioni, prima di qualsiasi crittografia, quando l'heap è basso, quando il database è in ritardo, quando ci sono troppi handshake in corso per core o per indirizzo di origine, oppure quando la frequenza degli handshake è troppo alta. Limiti di frequenza per dispositivo, code limitate, finestra TCP legata alla contropressione del broker, logging limitato, watchdog e health check.
- Immutabilità. Configurazione, CA e chiave del server sono incorporate nell'immagine. Cambiare qualsiasi cosa significa una nuova immagine.
Il modello delle minacce è descritto in docs/SECURITY.md.
Archiviazione senza file system
I dati risiedono su un disco separato, virtio-blk o virtio-scsi, privo di file system. Il layout è minimale e proprio:
LBA 0      [ superblocco: magic · versione del layout · uuid · tabella delle regioni · CRC-32C ]
LBA 8, 16  [ tabella delle dimensioni dei file, slot A/B (vince il più recente valido) ]
LBA 64     [ database principale SQLite ½ ][ WAL SQLite ⅛ ][ journal 1 MiB ][ log di telemetria: 8 partizioni … ]
ultimi 4 KiB [ area per l'autoverifica del dispositivo a blocchi all'avvio ]
SQLite (3.54.1 incluso nel repository, con verifica dell'hash in fase di build) è compilato nel kernel con clang, senza libreria standard, e usa un heap memsys5 di dimensione fissa. Il suo VFS mappa tre file fissi su regioni del disco. Funziona in modalità WAL con locking_mode=EXCLUSIVE, quindi non gli serve un indice in memoria condivisa, e con synchronous=FULL; se quick_check rileva un errore all'avvio, il sistema si ferma in modo sicuro. Nel database si trovano il registro dei dispositivi, le revoche, i messaggi retained e le sessioni persistenti con le code di messaggi QoS 1 per i dispositivi non connessi.
Il core del database, quello con il numero più alto, esegue SQLite e nient'altro. Il piano dati gli invia le variazioni di stato tramite un anello SPSC privo di lock; lui le raggruppa in un'unica transazione ogni 5 ms o ogni 512 operazioni e restituisce le conferme con un secondo anello. Un disco vuoto viene formattato al primo avvio; in ogni altro caso non si formatta mai sopra ciò che esiste.
La telemetria segue un altro percorso. Ogni PUBLISH accettato sui topic indicati in storage.telemetry_topics finisce nella partizione del log di telemetria del proprio core: un anello di segmenti con CRC per record, salato con la sequenza del segmento, in modo che i vecchi giri dell'anello non ricompaiano mai. I core passano i record al database con un anello proprio, senza copie, e questo li scrive ogni 5 ms o ogni 256 KiB. All'avvio il ripristino conserva ogni record scritto, tronca la coda incompleta e riprende in un nuovo segmento. La conservazione avviene per dimensione, attraverso l'anello, e per età, attraverso retention_days. Lo abbiamo verificato con un milione di record e con kill -9 nel bel mezzo della scrittura.
I numeri
Lo strumento di carico in tools/loadgen fa tre cose: una tempesta di handshake TLS 1.3 con mTLS e CONNECT, connessioni di lunga durata con PINGREQ che pubblicano telemetria ogni secondo, e tempeste di riconnessioni. make bench su un Apple M4 Pro sotto HVF dà:
| Core di lavoro | handshake/s nel guest | scalabilità | tramite rete utente QEMU (connessioni/s) |
|---|---|---|---|
| 1 | 862 | 1,00× | 789 |
| 2 | 1 724 | 2,00× | 636 |
| 4 | 3 438 | 3,99× | 536 |
Il dato nel guest, dove client e server si trovano nella stessa macchina virtuale e ogni core di lavoro opera per conto proprio, mostra che il piano dati scala in modo lineare. Il dato di rete è limitato dal networking utente a thread singolo di QEMU, non dal guest; anche questo è registrato come ADR-032.
Le tempeste di riconnessioni le proviamo facendo connettere tutti i dispositivi contemporaneamente, ripetendo con attesa i tentativi rifiutati e facendoli poi cadere tutti senza DISCONNECT. Il parametro heap_limit_mb= in modalità di sviluppo induce l'ammissione a ritenere l'heap più piccolo di quanto sia, così una tempesta più grande dell'heap si può provare con pochi socket. In uno di questi round con 3 000 dispositivi, 1 368 si sono connessi in 36 secondi e 5 619 tentativi sono stati rifiutati in modo ordinato, con un limite di 8 MiB; dopo la tempesta la memoria è tornata al livello iniziale.
Come lavoriamo
Il progetto è guidato da una specifica scritta, PROMPT.md, con il piano delle milestone, e ogni milestone si chiude con lo stesso rituale: make check e make smoke verdi, un commit con l'etichetta M<n>, una voce in docs/PROGRESS.md e un ADR per ogni decisione non ovvia. Le regole sono brevi e non negoziabili: nessun panic sull'input esterno, unsafe solo nei crate hardware e FFI e sempre con un commento, nessuna allocazione sul percorso caldo, un commento per ogni ordinamento delle operazioni atomiche, ogni limite proviene dalla configurazione, e le parti provvisorie intenzionali falliscono in modo rumoroso.
La CI fa più di quanto riusciremmo a fare a mano: fmt, clippy per l'host e per aarch64-unknown-none, typos, actionlint e shellcheck; test su Linux e macOS su arm64; build del kernel per la configurazione di sviluppo e di produzione con la dimensione dell'ELF nel riepilogo; avvio sotto QEMU con tutti gli scenari degli smoke test e salvataggio dei log seriali; cargo-deny per advisory, licenze e sorgenti; un minuto di fuzzing per ciascuno degli undici target, e di notte dieci minuti per target con corpus in cache. A ciò si aggiungono CodeQL, OpenSSF Scorecard, Dependabot e un rilascio con provenienza SLSA. Ogni action di terze parti è bloccata sull'SHA completo del commit.
La riproducibilità la prendiamo alla lettera: make repro compila HEAD due volte in alberi di lavoro puliti e confronta ELF, ISO e immagine raw byte per byte. I rilasci sono firmati con minisign e gli artefatti si possono verificare con gh attestation verify. L'immagine di produzione contiene la chiave privata del server, quindi l'ISO stesso è un segreto; le immagini allegate ai rilasci su GitHub sono di sviluppo, con chiavi temporanee, e servono solo per fare prove.
Che cosa abbiamo imparato
Alcune lezioni che hanno cambiato il piano:
- Un TCP proprio alla fine è valso la pena. Il prototipo girava su smoltcp e ci è stato utile fino a M13. Ma un server che mantiene centinaia di migliaia di connessioni non ha bisogno di un TCP lato client: servono SYN cookie, una timer wheel e uno stato di 96 byte. In M14 abbiamo sostituito smoltcp con uno stack proprio solo lato server, con test di perdita simulata e fuzzing dei segmenti.
- La memoria va misurata dall'interno. Le stime per connessione erano inutili finché il kernel non ha iniziato a contare da sé l'heap in blocchi dell'allocatore anziché in byte richiesti. Solo allora abbiamo visto dove vanno davvero a finire i 512 byte e siamo scesi a 494.
- Lo strumento di test fa parte del prodotto. Il limite maggiore non era il kernel, ma il networking utente di QEMU e il numero di porte effimere sul computer di sviluppo. Per centomila connessioni e oltre servono
vmnet-sharedsu macOS oppure Linux con KVM, interfaccia tap e più indirizzi client. - SQLite senza sistema operativo è possibile, ma solo a condizioni rigorose: heap fisso, lock esclusivo senza memoria condivisa, un VFS che non conosce i file, e un'ammissione che non lascia accumulare ritardo al database.
- Le tempeste di riconnessioni sono la normalità, non l'eccezione. Quando la rete mobile cade e poi torna, migliaia di dispositivi bussano nello stesso istante. Per questo l'ammissione rifiuta la connessione prima di qualsiasi crittografia, e ogni connessione rifiutata costa quasi nulla.
Che cosa viene dopo
Il lavoro successivo a M17 è pianificato in tre direzioni, e l'ordine tra di esse è registrato in docs/PLAN.md. Nulla di quanto segue è ancora stato realizzato.
- Un solo ISO per più piattaforme. Lo stesso file
urmqtt-<env>-<versione>.isoe un'unica immagine GPT raw che si avviano su UEFI aarch64, UEFI x86_64 e BIOS x86_64, in macchine virtuali e su hardware reale, a partire da un PC Intel. Sempre un appliance con tutto al proprio interno, riproducibile e firmato. - Disco raw, senza file system. Una specifica del formato a livello di byte, lo strumento host
urmqtt-diskche condivide i parser con il kernel, allineamento delle regioni a 1 MiB, crescita del disco con i dati, discard per i dischi thin provisioned, snapshot A/B del database, verifica dei bit e, a scelta, cifratura AES-256-XTS con AES hardware. - Sicurezza dimostrabile. Revoca e lista dei dispositivi consentiti a runtime tramite un canale di controllo firmato, senza una nuova immagine; test differenziali e di conformità del TLS e del TCP propri; KASLR, protezione dello stack, kCFI, MTE e un allocatore rinforzato; SQLite isolato a livello EL0; Secure Boot; SBOM e cargo-vet; e infine un pacchetto per la revisione esterna.
Le piattaforme che offrono soltanto dispositivi non virtio, come AWS ENA o Azure MANA, per ora non sono supportate. Raspberry Pi 4 e 5 come host KVM, Hetzner CAX e Oracle Ampere A1 sono documentati e supportati nel codice, ma non sono ancora stati provati su un servizio reale.
Provatelo
Il repository si trova su github.com/zeljan-alduk/urMQTT. Con Rust e la toolchain nightly fissata, QEMU, make certs, make run e un client mosquitto bastano per il primo PUBLISH su mTLS sul proprio computer. L'avvertenza iniziale vale anche alla fine: questo è pre-alfa, e tutto ciò che funziona è scritto in docs/PROGRESS.md. Segnalazioni di errori, domande sulla progettazione e segnalazioni di sicurezza secondo le indicazioni in SECURITY.md sono benvenute. Vi aggiorneremo qui a ogni prossima milestone.
Commenti
Regole dei commenti